聪明世界#10
编程顶尖
记性1M
便宜$25
记性换算成体感:一次能读完《哈利·波特》全七部
Claude Opus 系列的视觉模型 · 按发布时间
共 11 个 · 这里是相邻的 7 个 · Anthropic的全部模型 →他的房间
电脑
88.6% · SWE-bench Verified · 厂商自报,未经第三方复核
书架
5 层 · 记忆 1M tokens
黑板
数学与科学推理
日历
知识停在 2026-01
冰箱
支持上下文缓存,能存记忆
门禁
闭源,权重不公开
身世
- 发布日期
- 2026 年 5 月 27 日openrouter
- 知识截止
- 2026-01
- 参数量
- 体型为估算值,官方从未公布参数量
- 开放权重
- 否
- 开源许可
- 暂无数据
- 上下文窗口
- 1M tokens
- 单次最大输出
- 128K
- 输入价格
- $5.00 / 百万 tokens
- 输出价格
- $25 / 百万 tokens
- 模型类型
- 视觉除了文字还能看图片或视频,输出文字
- 支持的输入
- 图像、文件、文字 → 文字
- 工具调用
- 是
- 深度思考
- 是
- 提示缓存
- 是
战绩
- 综合智力
- 158.3
- AIME 数学
- 98.3%
- GPQA Diamond 科学
- 91.0%
- ARC-AGI-2 抽象推理
- 72.1%
- Fiction.liveBench 长文本
- 未参评
综合智力、数学、科学、抽象推理与长文本数据来自 Epoch AI(CC-BY 4.0)。写「未参赛」的项目表示该模型没有被这项评测收录, 不代表它做不到——本站不会用估算值填补空缺。
编程战绩(按赛制分列)
- 同样是 SWE-bench Verified,但分数来自厂商系统卡或其他榜单的转载,没有经过 Epoch 的统一复跑。第三方实测https://benchlm.ai/benchmarks/sweVerified
- SWE-Bench Pro69.2%同一个思路但难度高得多的版本,题目更长、依赖更复杂。分数普遍比 Verified 低三十分左右,两者不可直接比较。厂商自报https://www.anthropic.com/news/claude-opus-4-8
- DeepSWE59.0%SWE-bench Verified 的一个变体测法,用不同的 agent 脚手架跑同一批题。第三方实测https://deepswe.datacurve.ai/
- Terminal-Bench74.6%把模型丢进一个真实终端里让它自己干完一件活——装环境、跑脚本、调错。考的是当「实习生」的本事,不只是写代码。厂商自报https://www.anthropic.com/news/claude-opus-4-8
- CursorBench62.3%在真实 IDE 里做代码编辑的测试,题目来自 Cursor 收集的实际使用场景。第三方实测https://cursor.com/cursorbench
- LiveBench 智能体编程50.5%LiveBench 的智能体编程分项:不是写一段代码,而是像开发者那样多轮改动一个项目。第三方实测https://livebench.ai/#/?release=2026-06-25
- FrontierCode46.5%Cognition 出的高难度代码题集,面向前沿模型。第三方实测https://cognition.com/frontiercode
- LiveBench 编程分项81.8%LiveBench 每月换新题以避免污染,这一列是它的编程分项均分。第三方实测https://livebench.ai/#/?release=2026-06-25
- ALE-Bench1564AtCoder 启发式算法竞赛题,考的是给一个没有标准答案的优化问题找出尽量好的解。分数是 137–2177 的评分标度,不是百分比。和「修 bug」是两种能力。第三方实测https://epoch.ai/benchmarks
- GSO47.1%代码性能优化测试:在保持功能不变的前提下把真实项目跑得更快。第三方实测https://epoch.ai/benchmarks
- WebDev Arena1563 Elo让两个模型各写一个网页,由人来投票选哪个更好,按对战胜负算 Elo 分。考的是前端开发的实际观感,和「能不能修复一个后端 bug」不是一回事。第三方实测https://epoch.ai/benchmarks
这些分数不可互相比较。同一个模型换一套评测脚手架就能差二三十分: SWE-bench Verified 的中位数是 75.7,而难度更高的 SWE-Bench Pro 只有 41.0。 广场上的能力条因此显示的是「在同一把尺子下排第几」,而不是分数本身。
全部成绩(按榜单分列)
名次的分母是在同一个榜、由同一类测量方测过的模型数,不是全站模型数。不同榜的分数不可互相比较。
综合
- 综合智力158.3第 10 / 208Epoch Capabilities Index,把十几项学术评测归并成一个总分。想知道「谁最强」,先看这一栏。第三方实测https://epoch.ai/benchmarks
- SimpleBench64.8%第 14 / 103一套普通人能轻松答对、模型却常常答错的常识题。分数越高越少犯「一看就傻」的错。第三方实测https://simple-bench.com/
数学
- FrontierMath80.0%第 11 / 99由职业数学家出的原创难题,连数学博士都要花几小时甚至几天。分数是解出的比例,能过一成就是前沿水平。第三方实测https://epoch.ai/frontiermath
- FrontierMath(旧版)47.2%第 5 / 95FrontierMath 2025 年初的版本,已被新题库取代。留作历史对照。第三方实测https://epoch.ai/frontiermath
- FrontierMath 第四层56.1%第 11 / 71FrontierMath 里最难的一层,研究级别的问题,绝大多数模型接近零分。第三方实测https://epoch.ai/frontiermath
- FrontierMath 第四层(旧版)31.3%第 3 / 66FrontierMath 第四层 2025 年中的版本,已被新题库取代。第三方实测https://epoch.ai/frontiermath
- AIME 数学98.3%第 14 / 191美国高中数学邀请赛难度的模拟题,是数学竞赛能力的通行标尺。答对比例,满分 100。第三方实测https://epoch.ai/benchmarks
- ProofBench69.0%第 9 / 79不是算出答案,而是写出完整证明并由人评判。考的是数学推理的严谨程度。第三方实测https://www.vals.ai/benchmarks/proof_bench
知识与推理
- GPQA 科学91.0%第 26 / 197博士级别的物理、化学、生物选择题,题目设计到「谷歌也搜不到答案」。随机乱猜是 25 分。第三方实测https://epoch.ai/benchmarks
- ARC-AGI-272.1%第 14 / 108看几组图形样例找规律的智力题,人类轻松、模型艰难。专门测「没见过的题会不会做」。第三方实测https://epoch.ai/benchmarks
- ARC-AGI(第一代)92.5%第 16 / 107ARC-AGI 的第一代题库,已被第二代取代。第三方实测https://arcprize.org/
- SimpleQA 事实问答53.0%第 17 / 97一问一答的冷门事实题,测的是「知不知道」和「会不会瞎编」。分数低的模型更容易一本正经地胡说。第三方实测https://www.kaggle.com/benchmarks/deepmind/simpleqa-verified
- 深度研究50.2%第 8 / 38给一个开放的研究课题,让模型上网查资料写出报告,由人评质量。第三方实测
- CritPt 物理20.9%第 12 / 163研究级别的物理问题,由在职物理学家出题。测的是能不能做前沿科研级的推理。第三方实测
- WeirdML82.9%第 7 / 146一批刻意古怪的小型机器学习任务,模型要自己写代码训练并拿到成绩。考的是解决陌生问题的能力。第三方实测https://htihle.github.io/weirdml.html
智能体
- OSWorld 2.020.6%第 3 / 9OSWorld 的第二代题库,任务更长更杂,与第一代分数不可直接比较。第三方实测https://osworld-v2.xlang.ai/
- 经营售货机$5,787第 16 / 89Vending-Bench:让模型经营一台虚拟售货机一整年——进货、定价、付租金。分数是最后账上的钱,考的是长期不犯糊涂。第三方实测https://andonlabs.com/evals/vending-bench
- APEX 专业任务42.5%第 5 / 77投行、律所、咨询公司的真实工作任务,由业内专家出题与评分。第三方实测
- 远程工作指数8.3%第 2 / 18Remote Labor Index:从自由职业平台上取的真实外包项目,看模型能独立交付多少。分数普遍很低,说明离「替代远程工作者」还远。第三方实测
- PostTrainBench33.8%第 4 / 11让模型自己去微调一个更小的模型,考的是「会不会炼丹」。第三方实测
- BlueprintBench14.5%第 17 / 29看房屋照片画出平面图,测空间理解与工程绘图能力。第三方实测https://andonlabs.com/evals/blueprint-bench-2
- Surface Evolver87.5%第 5 / 30用一款专业的曲面数值软件完成计算任务,考的是驾驭陌生专业工具的能力。第三方实测https://yhenon.github.io/surface-evolver-llm-eval/
多模态
- GBA 游戏评测70.9%第 3 / 23看画面操作掌机游戏,测的是视觉理解加实时决策。第三方实测https://gbaeval.com/model/claude-opus-4-8
游戏与谜题
- 国际象棋残局34.0%第 29 / 156给一个棋局找出最佳着法。分数是解对的比例,随机乱走约 5 分。第三方实测https://epoch.ai/benchmarks/chess-puzzles
- 推理游戏谜题36.0%第 14 / 91Epoch 自建的一组推理小游戏,测的是在规则未知的环境里摸索规律。第三方实测https://epoch.ai/benchmarks
- EnigmaEval23.5%第 6 / 51解谜比赛里的复杂谜题,通常要综合图像、文字和多步推理。第三方实测https://labs.scale.com/leaderboard/enigma_eval
- EBR-bench28.6%第 8 / 27Epoch 自建的一项评测,具体口径以 Epoch 榜单页说明为准。第三方实测https://epoch.ai/benchmarks
其他
- Dtbench94.9%第 12 / 198Epoch AI 收录的评测,暂无中文说明。第三方实测https://conceptualreasoning.ai/dtbench
- Lmca57.5%第 5 / 183Epoch AI 收录的评测,暂无中文说明。第三方实测https://conceptualreasoning.ai/lmca
B 站上的 Claude Opus 4.8 实测2 个视频
在 B 站搜「Claude Opus 4.8 测评」↗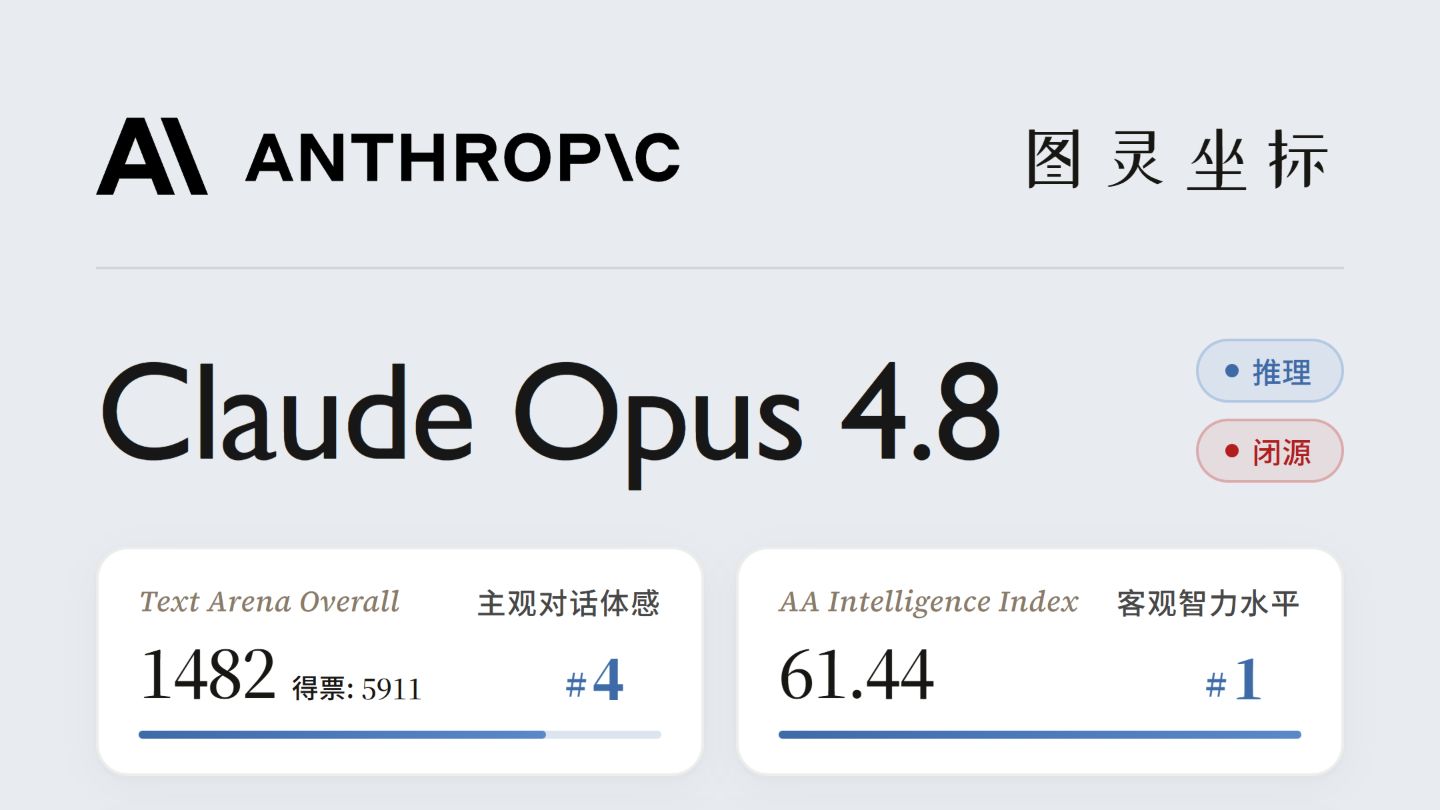 03:52听说 Claude Opus 4.8 蒸馏了 Qwen 和 DeepSeek ,到底是蒸馏还是防蒸馏有没有懂的?| 浪浪妈雷达图图灵坐标2026.06.06·8.4 万播放
 05:52如何付费使用Claude Opus 4.8满血版 (教程00:34开始)大吃一顿鲸2026.05.29·3.9 万播放
以上为 B 站搜索结果,按播放量排(站长的视频置顶),内容由各 UP 主提供,不代表本站观点。